Chi siamo
Il Laboratorio di Bioinformatica dell'Università del Sannio è diretto da Luigi Cerulo e Francesco Napolitano e si occupa di biologia dei sistemi, analisi di dati omici basata sull'intelligenza artificiale e drug discovery computazionale.
Biologia dei sistemi
Esploriamo i dati biologici per svelare meccanismi molecolari complessi.

Analisi di dati omici con l'IA
Usiamo l'intelligenza artificiale per fare previsioni biologiche a partire dai dati omici.
Drug discovery computazionale
Identifichiamo piccole molecole per applicazioni cliniche e di laboratorio.
Le attività di ricerca in bioinformatica all'Università del Sannio furono avviate nel 2000 da Michele Ceccarelli, con un focus sullo studio dei processi informatici nei sistemi biologici. Con la crescita esponenziale dei dati biologici, il laboratorio si è orientato verso gli approcci di data science in bioinformatica, sotto la co-direzione di Luigi Cerulo a partire dal 2009. Dal 2021 il Laboratorio di Bioinformatica è diretto da Luigi Cerulo e Francesco Napolitano e impiega tecniche avanzate per esplorare i dati biologici, predire meccanismi molecolari e identificare nuovi farmaci e bersagli terapeutici, contribuendo all'innovazione della ricerca in bioinformatica.
News e pubblicazioni
Congratulazioni Maria Chiara, Roberto e Giorgia!
Maria Chiara Armenise, Roberto Paduano e Giorgia Miano hanno conseguito la Laurea in Biotecnologie con tesi svolte nel nostro laboratorio, sul pensiero computazionale nelle biotecnologie e nella didattica STEM, sulla specializzazione dei Large Language Models per la bioinformatica con LoRA e sull'IA generativa e i foundation model multimodali in oncologia. Congratulazioni a tutti e tre!
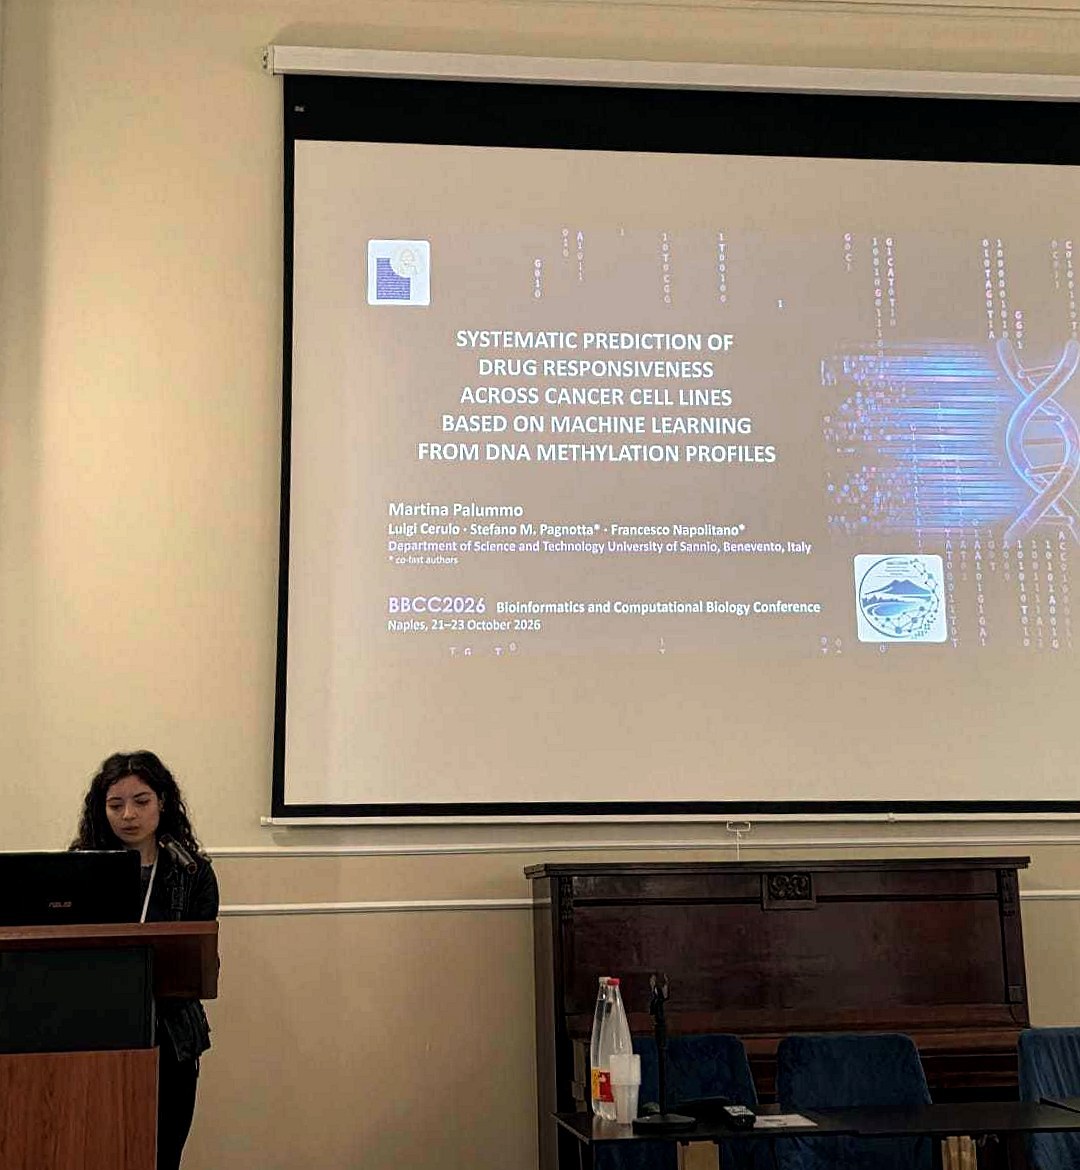
Il nostro laboratorio a BBCC2026 a Napoli
Martina Palummo ha presentato il nostro lavoro "Systematic prediction of drug responsiveness across cancer cell lines based on machine learning from DNA methylation profiles" a BBCC2026, la 21ª Bioinformatics and Computational Biology Conference, tenutasi al Chiostro San Francesco di Napoli dal 21 al 23 ottobre 2026. Lavoro congiunto con Luigi Cerulo, Stefano M. Pagnotta e Francesco Napolitano.
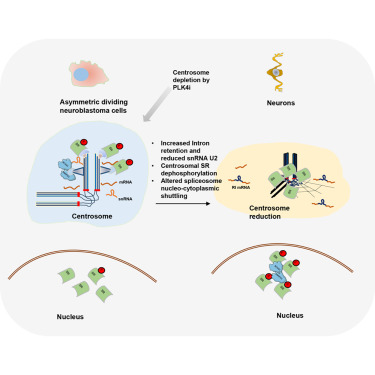
Meno centrosomi, neuroni più maturi: la perdita del centrosoma riprogramma lo splicing
I centrosomi organizzano la divisione cellulare, ma potrebbero anche contribuire a decidere il destino di una cellula. Nelle cellule staminali di neuroblastoma, questo studio ha trovato componenti dello splicing come gli snRNA U2 e U5 e il fattore di splicing SRSF2 sulle appendici subdistali del centrosoma. Eliminare i centrosomi prima del trattamento con acido retinoico ha reso più efficiente la maturazione delle cellule in neuroni, insieme a un aumento della ritenzione intronica e alla defosforilazione dei fattori di splicing SR al centrosoma. Il nostro laboratorio ha curato le analisi bioinformatiche, condotte da Luca Faretra e Marco Nigro, in uno studio coordinato da Massimo Pancione con partner dell'Università di Napoli Federico II, del TIGEM e dell'IRCCS Casa Sollievo della Sofferenza.
“Centrosome depletion reprograms RNA splicing to promote neuroblastoma differentiation through SR factor dephosphorylation”
iScience
University of Sannio · University of Naples Federico II · TIGEM · IRCCS Casa Sollievo della Sofferenza · Biogem · University of Verona · University of Bari · Policlinico Gemelli IRCCS · Université de Tours · Complutense University of Madrid
Leggi l'articolo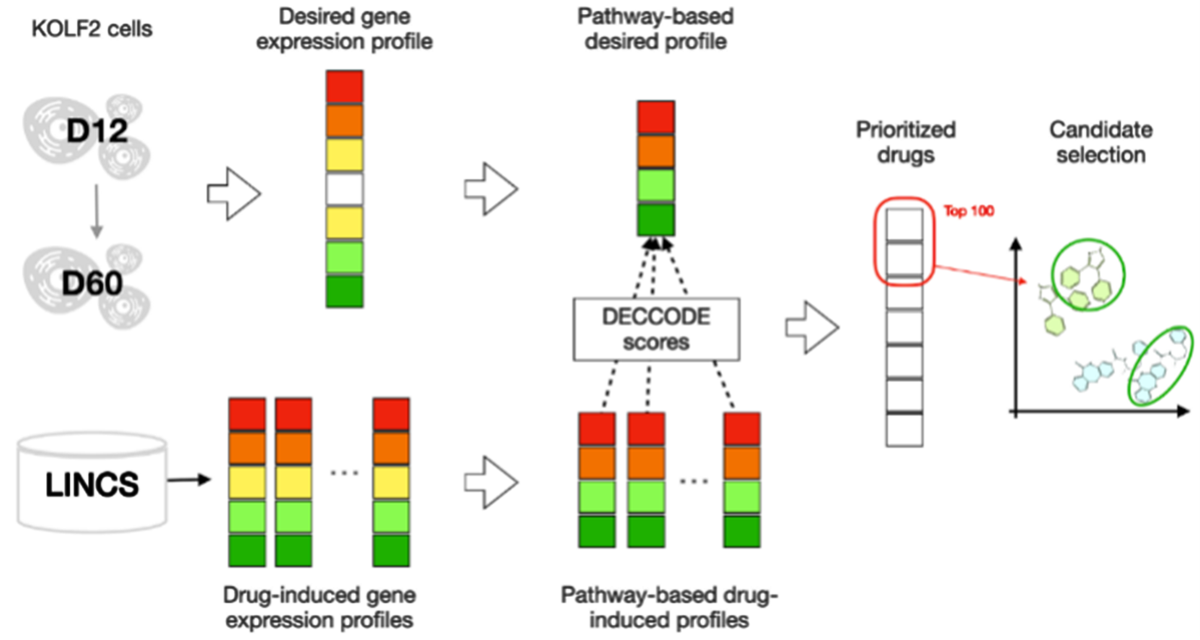
Farmaci già approvati che attivano il tessuto adiposo bruno umano
Il tessuto adiposo bruno consuma energia per produrre calore, il che lo rende un bersaglio interessante contro l'obesità e le malattie metaboliche. In questo studio, l'approccio DECCODE ha confrontato il profilo trascrizionale di adipociti bruni derivati da cellule staminali umane con i profili indotti da farmaci del database LINCS, alla ricerca di piccole molecole che ne favoriscano l'attivazione e il differenziamento. Due farmaci già approvati per altri usi, saxagliptin e tolvaptan, hanno aumentato in modo significativo l'attivazione termogenica in cellule umane, aprendo nuove opportunità di riposizionamento farmacologico. Una collaborazione con l'Università di Cambridge, lo Swiss Institute of Bioinformatics, il CIPF di Valencia e KAUST.
“Data-driven identification of small molecules inducing brown adipocyte activation and differentiation”
Biology Direct
University of Sannio · University of Cambridge · Swiss Institute of Bioinformatics · CIPF Valencia · KAUST, Saudi Arabia
Leggi l'articolo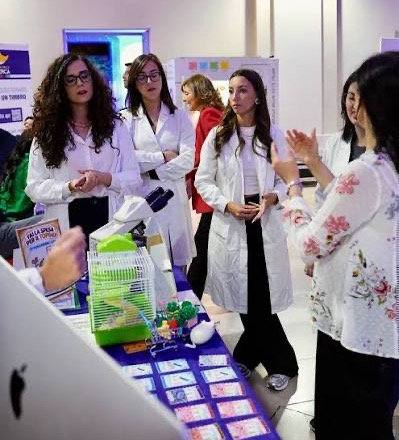
Il Laboratorio di Bioinformatica alla Notte della Ricerca
Il nostro laboratorio ha partecipato alla Notte della Ricerca a Palazzo San Domenico, sede del Rettorato di UniSannio, con due stand dedicati alla genomica e al microbiota. Entrambi hanno avuto un grande successo tra visitatori di tutte le età, dai bambini curiosi agli adulti più inquisitivi. Guarda il servizio del TGR Campania della RAI, che racconta anche le altre ricerche di UniSannio in mostra quella sera!

UniSannio Summer School - Biotech Crime Lab, il DNA non mente

Perché un introne resta? Leggere la ritenzione intronica nella sequenza del DNA
La maggior parte degli introni viene rimossa dai trascritti attraverso lo splicing, ma alcuni vengono trattenuti selettivamente: una forma di splicing alternativo che contribuisce alla regolazione genica. In questo studio guidato dal nostro dottorando Luca Faretra abbiamo estratto le unità esone-introne-esone dell'intero genoma umano, descrivendo ciascuna con un ampio insieme di caratteristiche di sequenza, dalla forza dei siti di splicing e il contenuto in GC fino agli elementi trasponibili e alle firme delle proteine che legano l'RNA. I modelli di machine learning mostrano che la tendenza a essere trattenuto nasce dall'interazione di molti fattori, con la lunghezza dell'introne e il contenuto in GC come predittori più forti. Interamente sviluppato nel nostro laboratorio, in collaborazione con Biogem.
“Decoding exonic intron retention from sequence: an exploratory study in the human genome”
Frontiers in Bioinformatics
University of Sannio · Biogem
Leggi l'articolo
Il progetto RegenAI verso la conclusione
RegenAI è un progetto co-diretto dal Prof. Napolitano in collaborazione con l'Università Federico II di Napoli e finanziato come Progetto di Rilevante Interesse Nazionale (PRIN). Il progetto mira a identificare molecole terapeutiche per la retinite pigmentosa, una malattia degenerativa dell'occhio che causa la perdita della vista. Maggiori informazioni sul sito collegato.

Il Prof. Napolitano presidente dei Corsi di Studio in Biotecnologie
Il Prof. Napolitano, co-direttore del Laboratorio di Bioinformatica, è stato nominato Presidente dei Corsi di Laurea Triennale e Magistrale in Biotecnologie. Il mandato durerà tre anni a partire da oggi. Buon lavoro!

Congratulazioni Chiara Circelli Gabriele!
Chiara ha conseguito la Laurea in Scienze Biologiche discutendo una tesi dal titolo "Meta-analisi degli studi di trascrittomica in endometriosi: prospettive per target terapeutici".

Farmaci che potenziano le cellule ingegnerizzate, trovati al computer
Le cellule di mammifero ingegnerizzate con circuiti genetici sintetici sono al centro della prossima generazione di bioterapie, ma la loro produttività è limitata dalle risorse cellulari disponibili. Usando DECCODE, un metodo computazionale di drug matching sviluppato dal Prof. Napolitano, gli autori hanno confrontato il profilo trascrizionale di cellule che esprimono un circuito capace di migliorarne le prestazioni con migliaia di profili indotti da farmaci, alla ricerca di molecole che ne riproducano l'effetto senza ulteriori modifiche genetiche. Il candidato migliore, il Filgotinib, ha aumentato l'espressione dei payload genetici in diverse linee cellulari e sistemi di delivery, tra cui AAV e lentivirus. Una collaborazione guidata dal laboratorio di Velia Siciliano all'IIT di Napoli, con TIGEM, Federico II e CNR.
“Computational identification of small molecules for increased gene expression by synthetic circuits in mammalian cells”
Nature Communications
IIT Naples · TIGEM · University of Naples Federico II · CNR-IAC Naples · University of Sannio
Leggi l'articolo
Congratulazioni Manuel Maio!
Manuel ha conseguito la Laurea in Biotecnologie discutendo una tesi dal titolo "I.A. e Farmacologia: un'analisi di Knowledge Probing su DeepSeek".
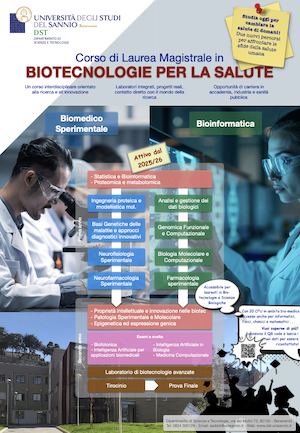
Nuova Laurea Magistrale in Biotecnologie per la Salute / Bioinformatica
Nell'ambito della nuova Laurea Magistrale in Biotecnologie per la Salute, a partire dall'Anno Accademico 2025/26, prende il via un curriculum in Bioinformatica!
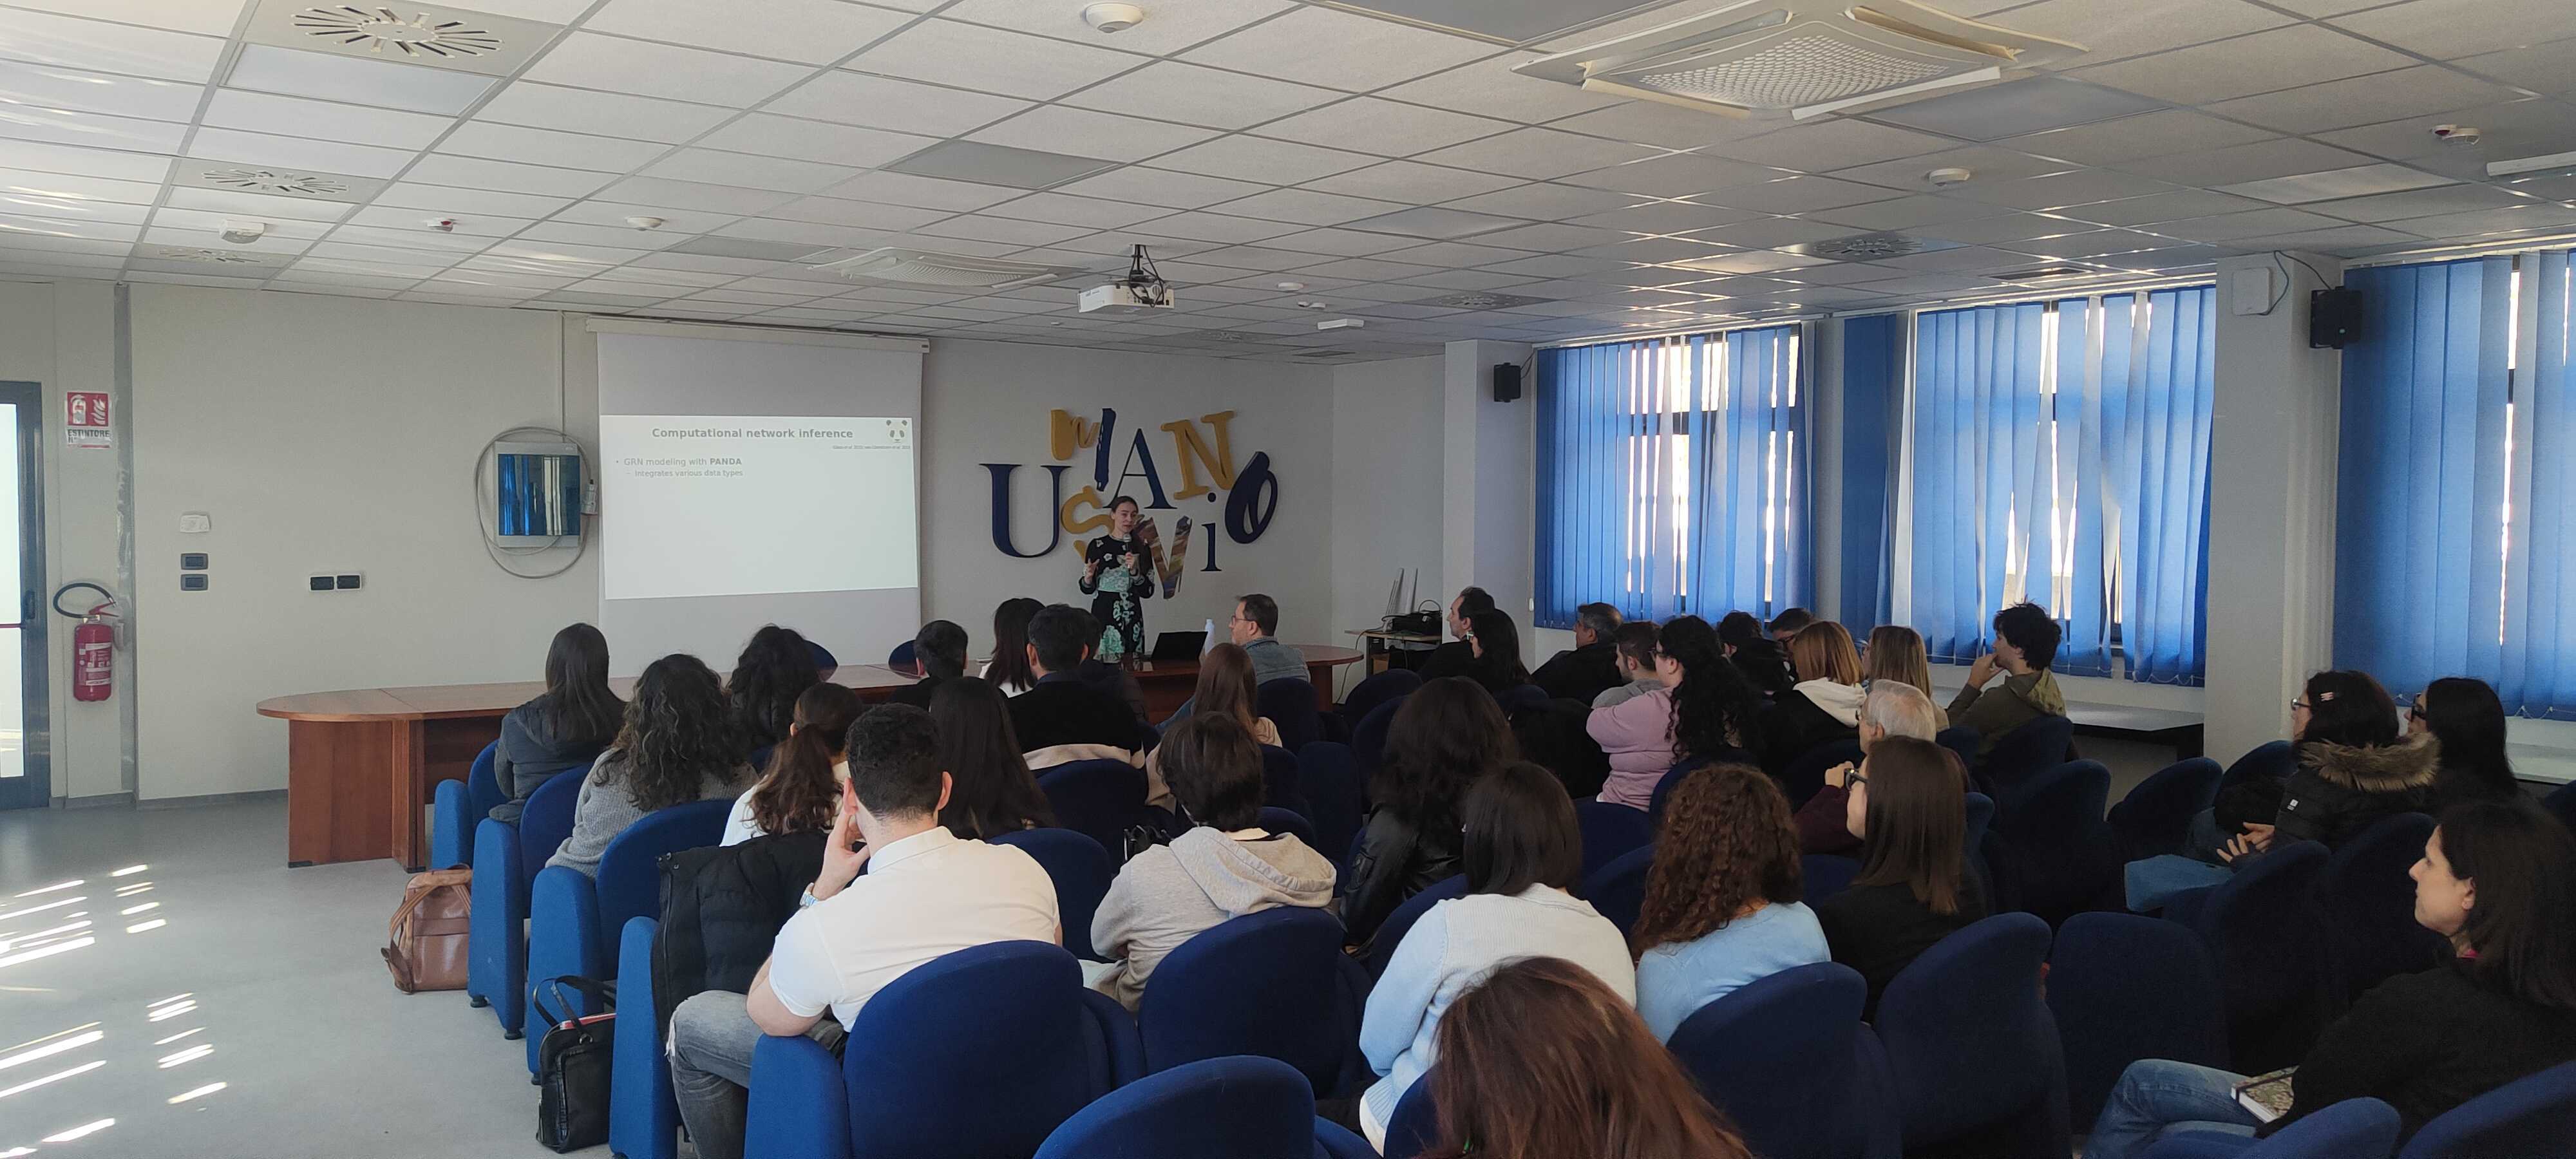
La Prof.ssa Marieke Kuijjer in visita al laboratorio!
Marieke Kuijjer, Associate Professor in Cancer Data Science presso l'iCAN Flagship dell'Università di Helsinki (Finlandia) e Group Leader del gruppo Computational Biology and Systems Medicine al Centre for Molecular Biosciences and Medicine Norway (NCMBM), Nordic EMBL Partnership, Università di Oslo (Norvegia), ha visitato il nostro laboratorio per uno scambio scientifico. Ha presentato il suo lavoro sul rimodellamento delle reti geniche nel cancro in un seminario al Dipartimento di Scienze e Tecnologie. È stato uno scambio molto proficuo!
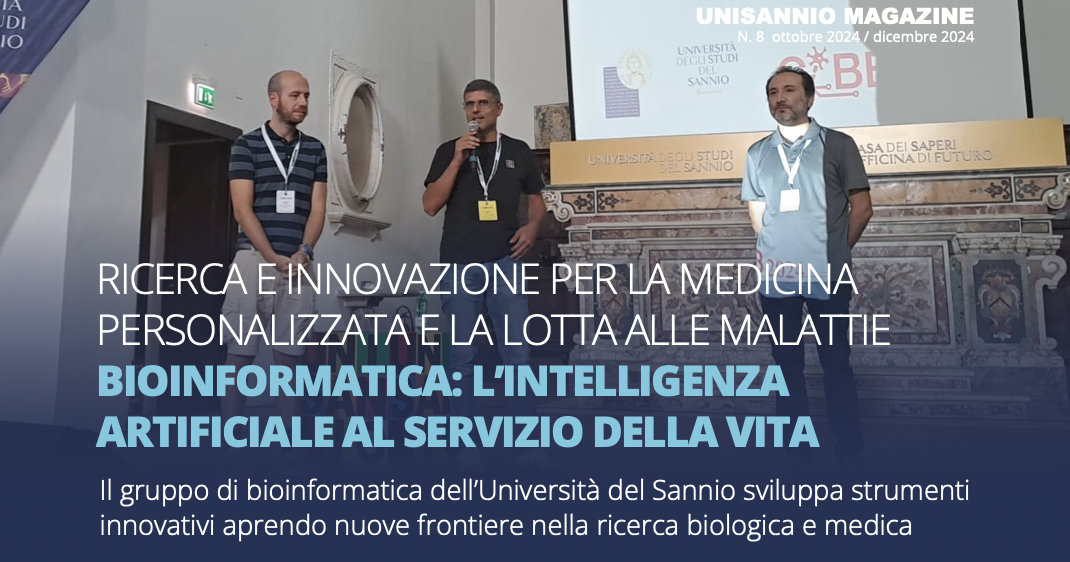
Il BioinfoLab su UniSannio Magazine
Cos'è la bioinformatica e di cosa ci occupiamo al BioinfoLab di UniSannio? Ce lo ha chiesto UniSannio Magazine e siamo stati felici di rispondere!
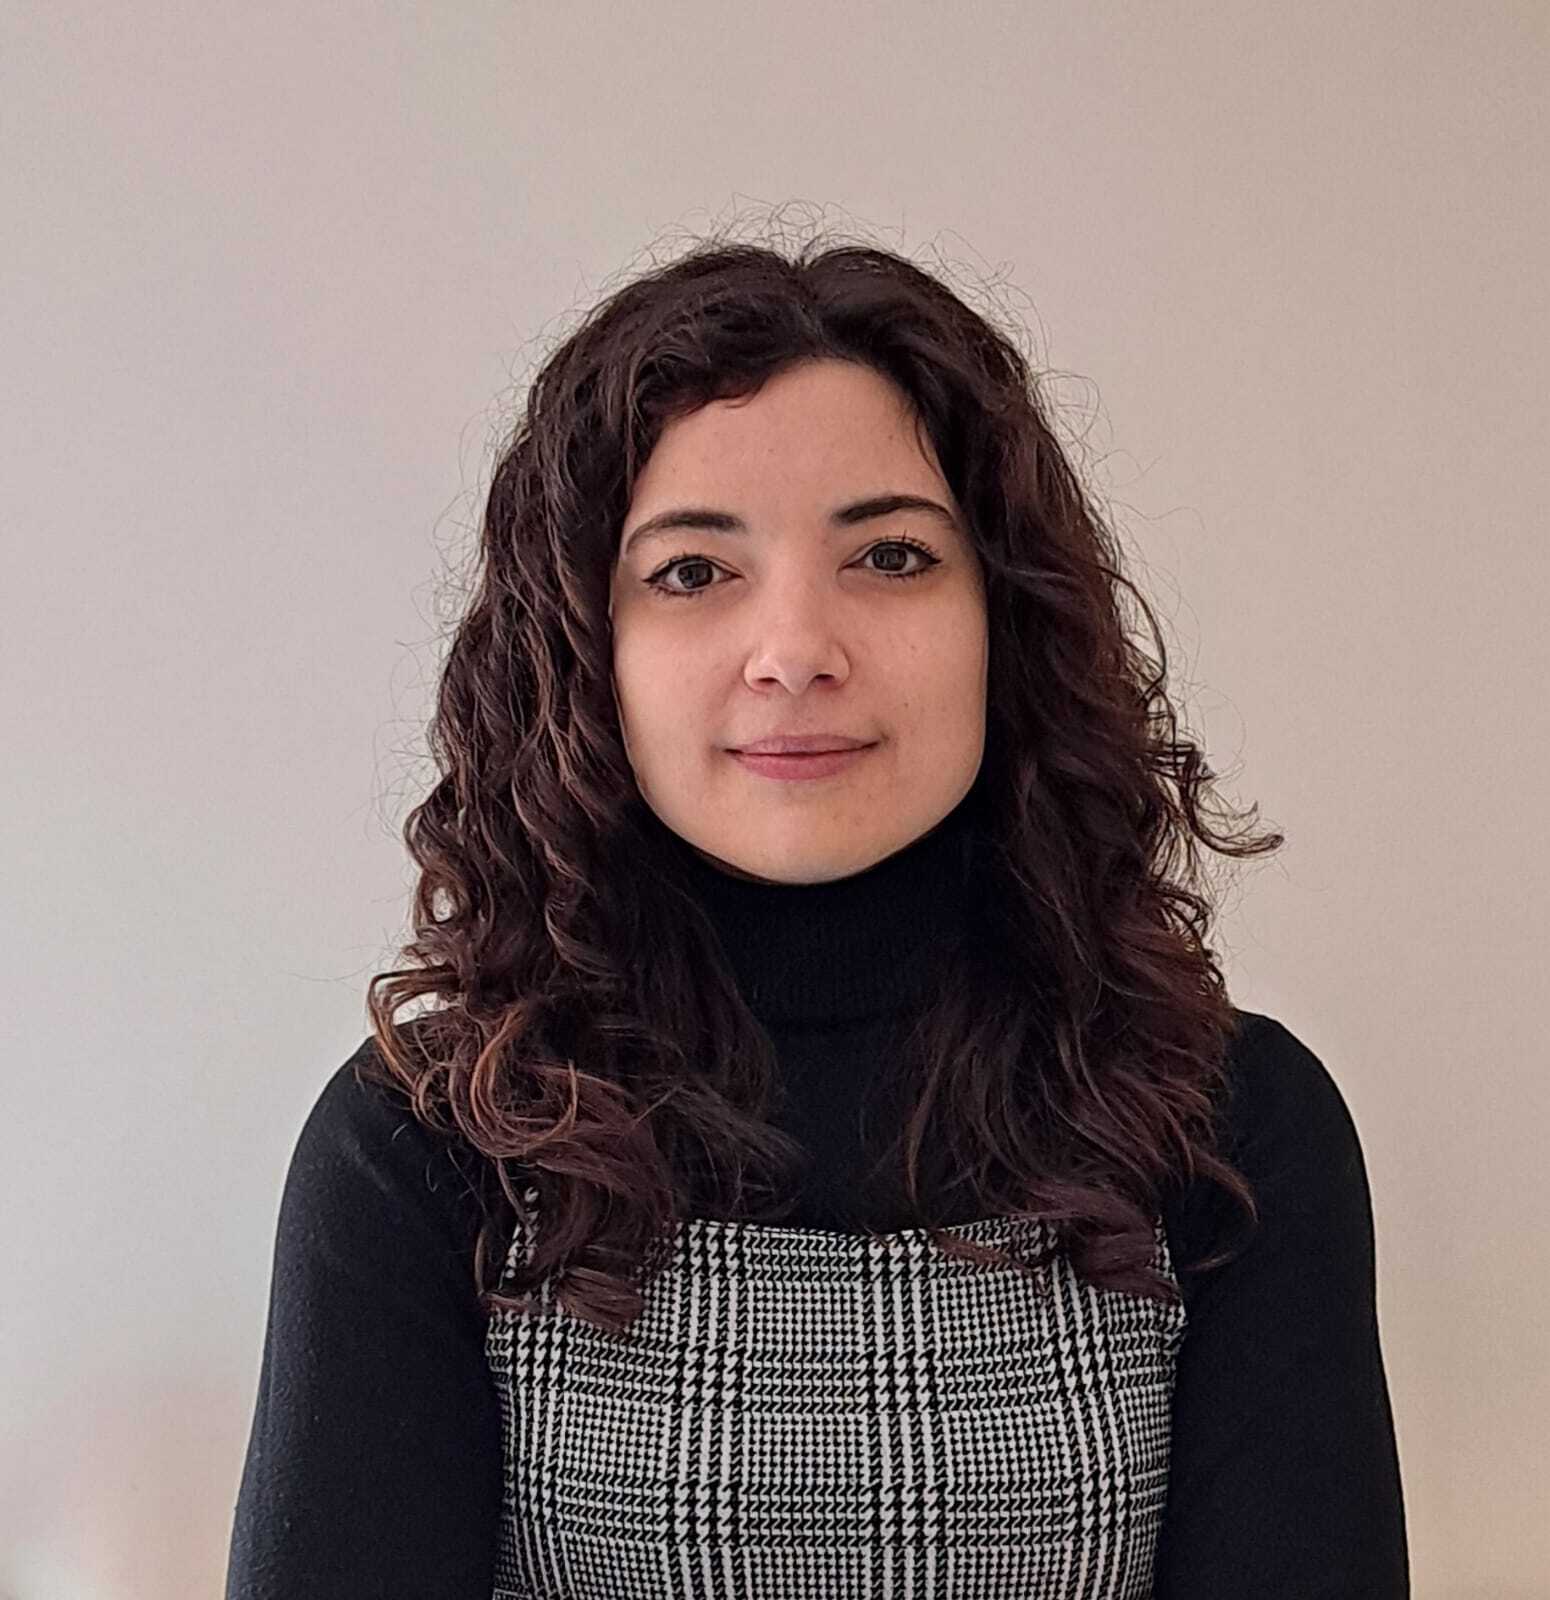
Benvenuta Martina!
Martina Palummo è appena entrata nel nostro gruppo come ricercatrice postdoc! Trovi più informazioni su di lei nella sezione Persone qui sotto.
Futuro Remoto
Il laboratorio sarà presente a Futuro Remoto 2024 per mostrare le applicazioni della bioinformatica agli studenti delle scuole medie e superiori.
Benvenuta Mirella!
Mirella Sangiovanni è appena entrata nel nostro gruppo come ricercatrice in visiting! Trovi più informazioni su di lei nella sezione Persone qui sotto.
Benvenuta Erica!
Erica Cogliano è appena entrata nel nostro gruppo come tirocinante! Trovi più informazioni su di lei nella sezione Persone qui sotto.
Benvenuto Marco!
Marco Nigro è appena entrato nel nostro gruppo come ricercatore postdoc! Trovi più informazioni su di lui nella sezione Persone qui sotto.
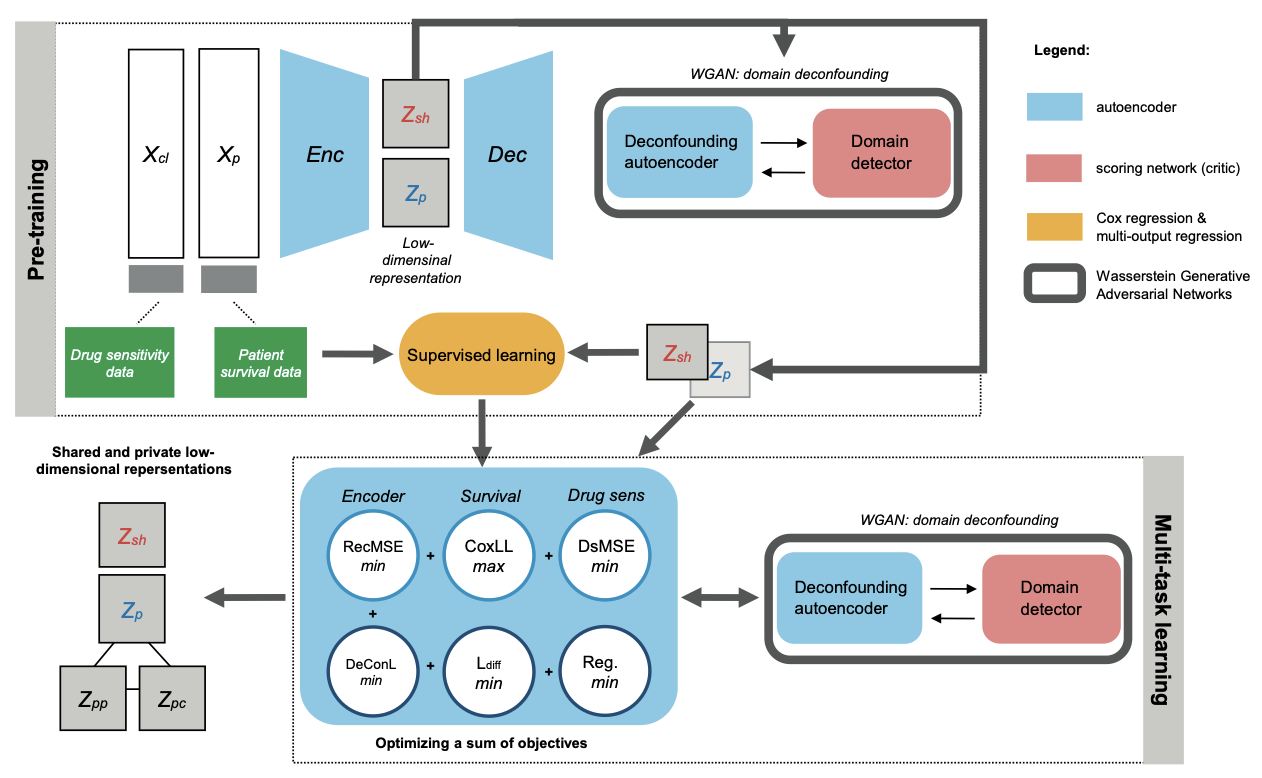
MODAE: deep learning per collegare linee cellulari e pazienti
Gli screening farmacologici su linee cellulari tumorali sono alla base di gran parte dello sviluppo di nuovi farmaci, ma le linee cellulari differiscono dai tumori reali dei pazienti. L'articolo presenta MODAE, un modello di deep learning che integra profili omici di linee cellulari e di pazienti e impara a predire contemporaneamente la sensibilità ai farmaci e la sopravvivenza. Tenere conto della sopravvivenza aiuta a preservare le differenze tra pazienti clinicamente rilevanti, offrendo un nuovo modo, basato sull'IA, per prioritizzare i trattamenti per i pazienti ad alto rischio. Lavoro congiunto con la University of Eastern Finland; il codice è liberamente disponibile su GitHub.
“Multi-task deep latent spaces for cancer survival and drug sensitivity prediction”
Bioinformatics
University of Eastern Finland · University of Sannio
Leggi l'articolo
CIBB 2024 è stato un successo!
Si è appena conclusa la 19ª edizione della conferenza Computational Intelligence methods for Bioinformatics and Biostatistics, con grande successo! Informazioni (e foto) su http://cibb2024.unisannio.it!
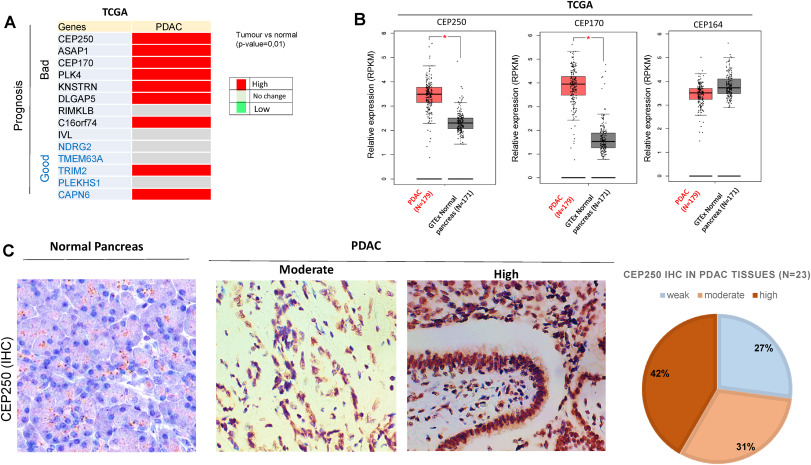
Geni del centrosoma legati alla prognosi del tumore del pancreas
L'adenocarcinoma duttale del pancreas è tra le principali cause di morte per cancro, e le sue cellule presentano spesso centrosomi anomali. Analizzando dati pubblici di RNA-sequencing, lo studio ha identificato due geni del centrosoma, CEP250 e CEP170, la cui elevata espressione è associata a una prognosi peggiore, confermando i risultati su tessuti di pazienti. In una piccola coorte di validazione, i pazienti con livelli elevati di CEP250 hanno mostrato una sopravvivenza più breve e una risposta rara alla chemioterapia di prima linea, mentre livelli bassi erano associati ai lungo-sopravviventi. Una collaborazione con l'Università di Foggia, l'Università Federico II di Napoli e Biogem.
“Altered centriolar cohesion by CEP250 and appendages impact outcome of patients with pancreatic cancer”
Pancreatology
University of Foggia · University of Sannio · University of Naples Federico II · Biogem
Leggi l'articolo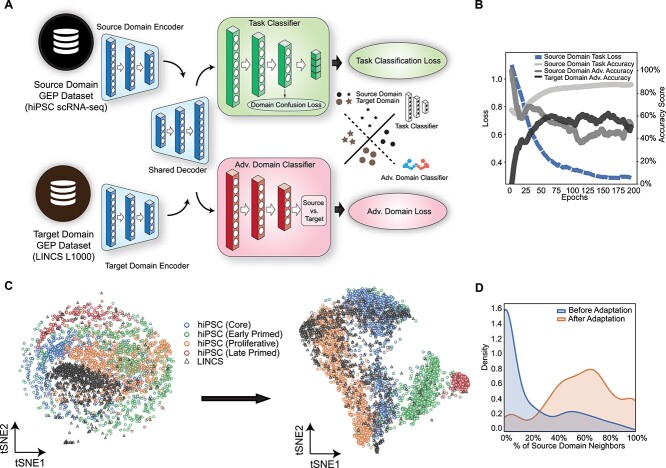
L'IA trova farmaci che spingono le cellule staminali del cancro al seno a differenziarsi
Le cellule staminali tumorali sono una piccola popolazione con caratteristiche staminali all'interno dei tumori, e indurne il differenziamento è una strada promettente verso la remissione a lungo termine. In questo lavoro, una rete neurale profonda addestrata su dati single-cell di cellule staminali pluripotenti umane è stata usata per analizzare migliaia di profili di espressione indotti da farmaci del database LINCS, con l'adversarial learning a rimuovere il bias tra i due tipi di dati. Cinque delle sei molecole meglio classificate, testate su linee cellulari di cancro al seno, si sono dimostrate efficaci, tra cui triptolide, OTS-167 e chinacrina. Una collaborazione con KAUST (Arabia Saudita) e CNR-IEOS Napoli.
“AI identifies potent inducers of breast cancer stem cell differentiation based on adversarial learning from gene expression data”
Briefings in Bioinformatics
KAUST, Saudi Arabia · CNR-IEOS Naples · University of Sannio
Leggi l'articolo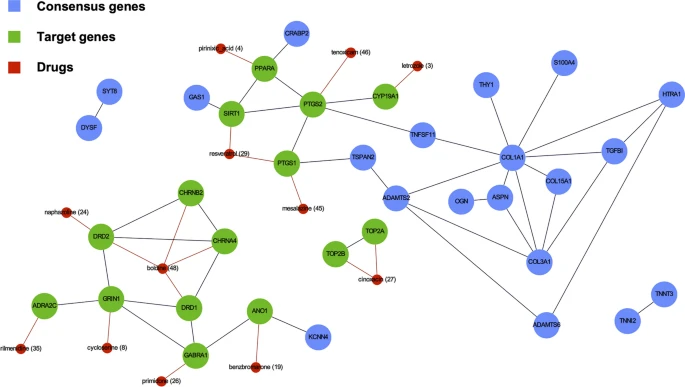
Nuovi candidati farmaci e un punteggio di rischio per l'artrosi
L'artrosi colpisce una larga parte della popolazione di mezza età e le terapie attuali sono ancora poco efficaci. Combinando tre coorti di pazienti, lo studio ha ricavato una firma condivisa di 44 geni coinvolti nella malattia. Una prioritizzazione dei farmaci basata sulle reti ha indicato candidati come resveratrolo, tenoxicam e mesalazina, e sette geni bersaglio sono stati confermati in vitro. Gli autori propongono inoltre un punteggio di rischio basato su appena otto geni, che predice lo stadio clinico della malattia a partire da dati RNA-Seq. Una collaborazione con l'Università Federico II di Napoli, Biogem, CNR, IRCCS SYNLAB SDN e l'Università di Miami.
“Identification of therapeutic targets in osteoarthritis by combining heterogeneous transcriptional datasets, drug-induced expression profiles, and known drug-target interactions expression data”
Journal of Translational Medicine
University of Naples Federico II · Biogem · CNR-IAC Naples · IRCCS SYNLAB SDN · University of Sannio · University of Miami
Leggi l'articolo
Ospitiamo CIBB 2024!
Stiamo organizzando la 19ª edizione della conferenza Computational Intelligence methods for Bioinformatics and Biostatistics. Tutte le informazioni su http://cibb2024.unisannio.it!
Software
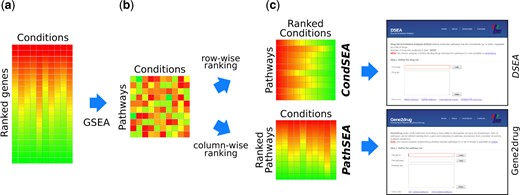
Pacchetto R/Bioconductor gep2pep
I Pathway Expression Profiles (PEP) si basano sull’espressione dei pathway (definiti come insiemi di geni) anziché dei singoli geni. Il pacchetto converte i profili di espressione genica in PEP ed esegue analisi di arricchimento sia dei pathway sia delle condizioni sperimentali, come la “drug set enrichment analysis” e l’analisi di drug discovery “gene2drug”.
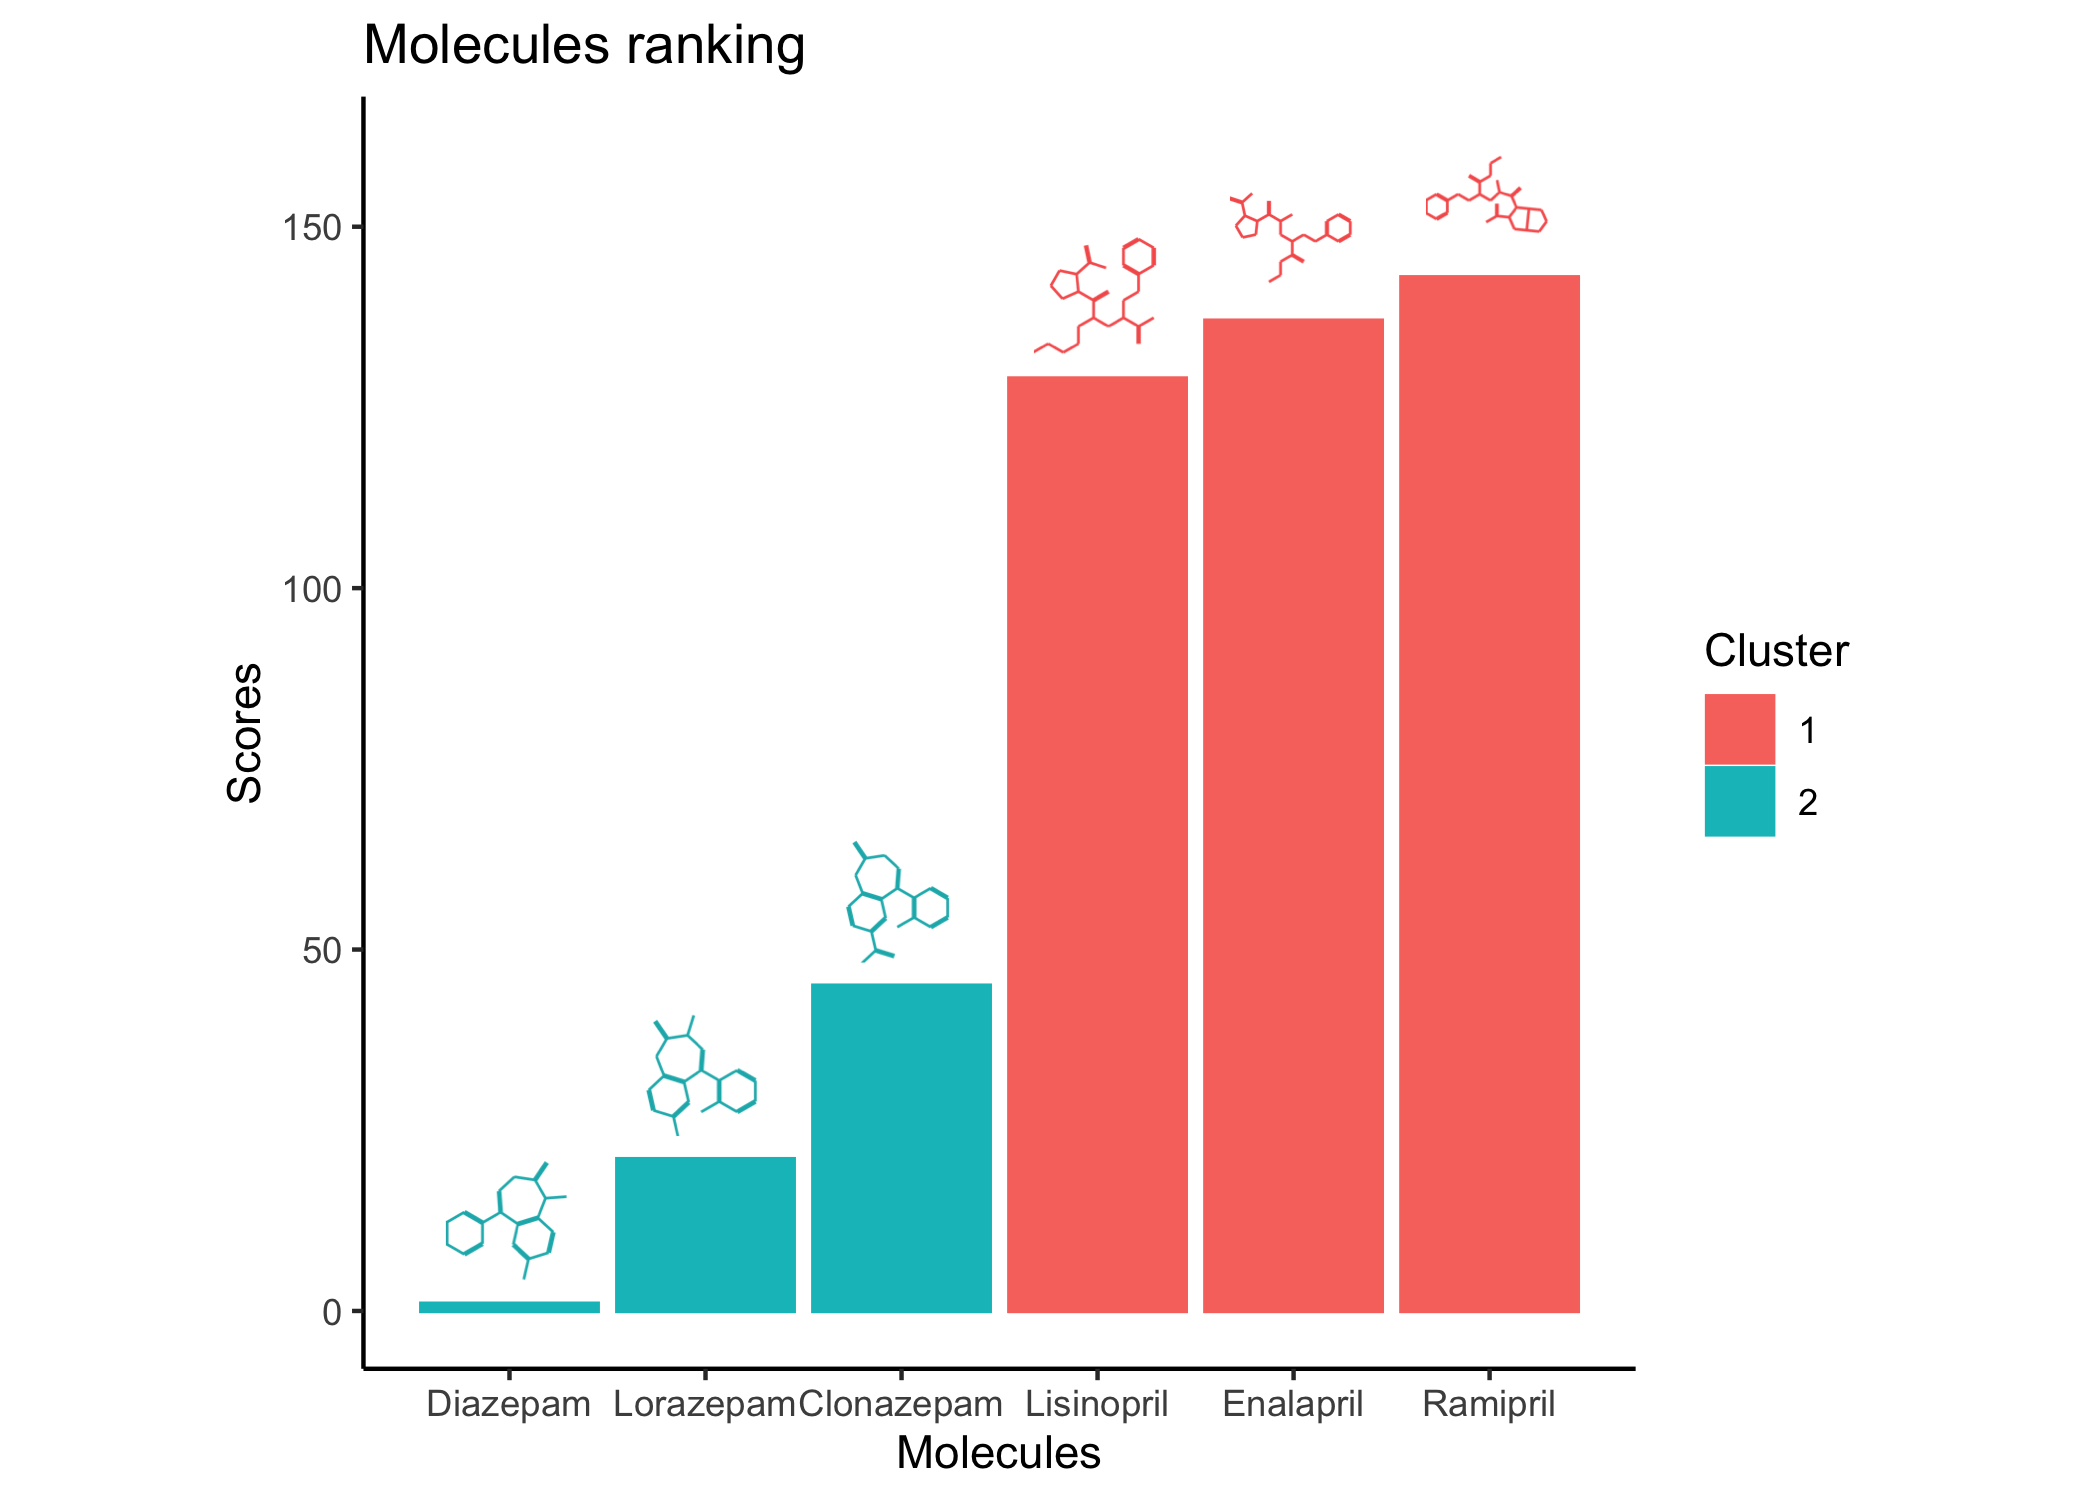
Pacchetto R ggmol
Un pacchetto R per creare visualizzazioni di piccole molecole pronte per la pubblicazione, all’interno del framework ggplot2. Il pacchetto è costruito su ChemmineR e semplifica la visualizzazione basandosi soltanto sulle stringhe SMILES delle molecole.
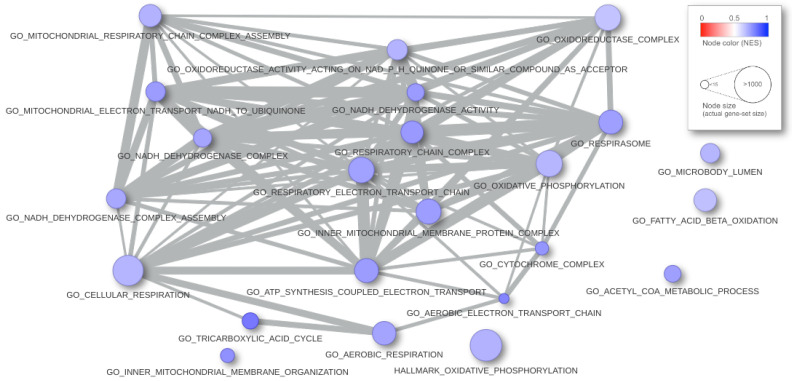
Pacchetto R e strumento web massiveGST
Uno strumento di gene-set enrichment analysis basato sul test di Mann-Whitney-Wilcoxon, disponibile come pacchetto R su CRAN e come servizio web. Oltre ai p-value fornisce un Normalized Enrichment Score con un’interpretazione probabilistica diretta, insieme a risultati tabellari e grafici pensati per la ricerca riproducibile.
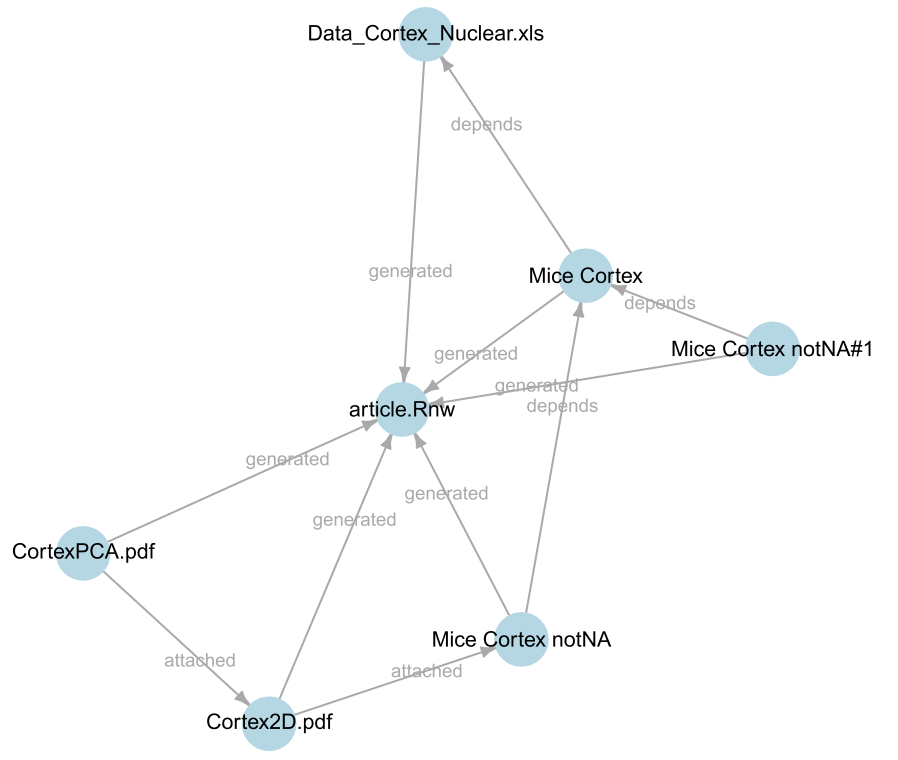
Pacchetto R Repo
Un gestore di dati per l’ambiente R pensato per astrarre le operazioni sul file system. Costruisce uno o più repository centralizzati in cui gli oggetti R vengono archiviati insieme ad annotazioni dettagliate, inclusi frammenti di codice, rendendo semplice cercare e recuperare i dati.
Strumenti didattici
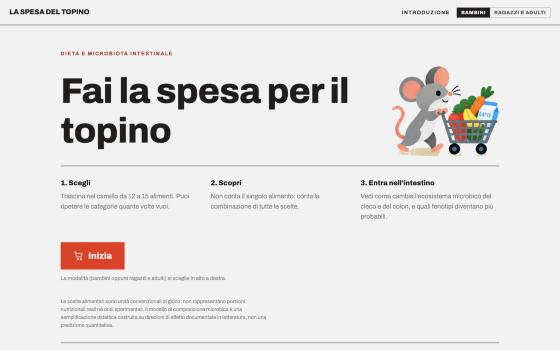
La spesa del topino
Un gioco didattico sulla dieta e sul microbiota intestinale: si riempie il carrello della spesa di un topino e si scopre come la combinazione degli alimenti modifica l’ecosistema microbico dell’intestino. Include modalità per bambini e per ragazzi e adulti. Sviluppato con il gruppo di Fisiologia.
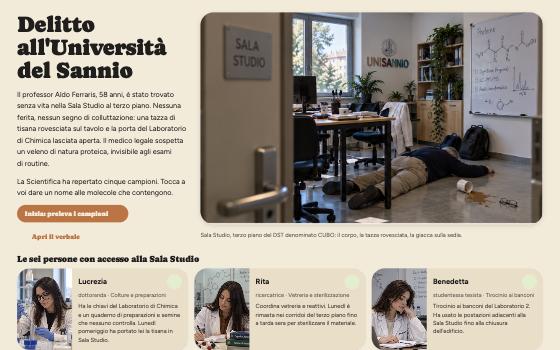
Delitto all'Università del Sannio
Un giallo ambientato nel nostro Dipartimento: un professore viene trovato morto, avvelenato da una tossina di natura proteica, e i giocatori devono identificare le molecole presenti in cinque campioni forensi per scoprire il colpevole. Sviluppato con il gruppo di Genetica.
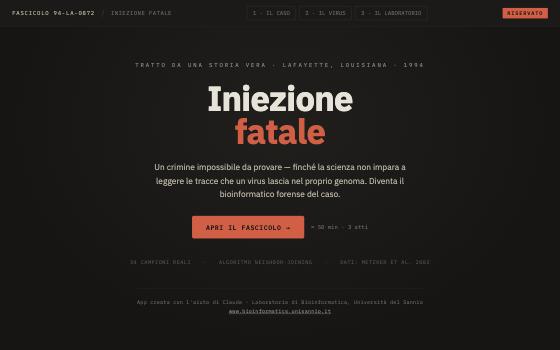
Iniezione fatale
Ispirato a una storia vera (Lafayette, Louisiana, 1994), il gioco trasforma i partecipanti in bioinformatici forensi che ricostruiscono una filogenesi virale con l’algoritmo neighbor-joining su 34 campioni reali (Metzker et al., 2002) per risolvere il caso.
Infrastrutture
-
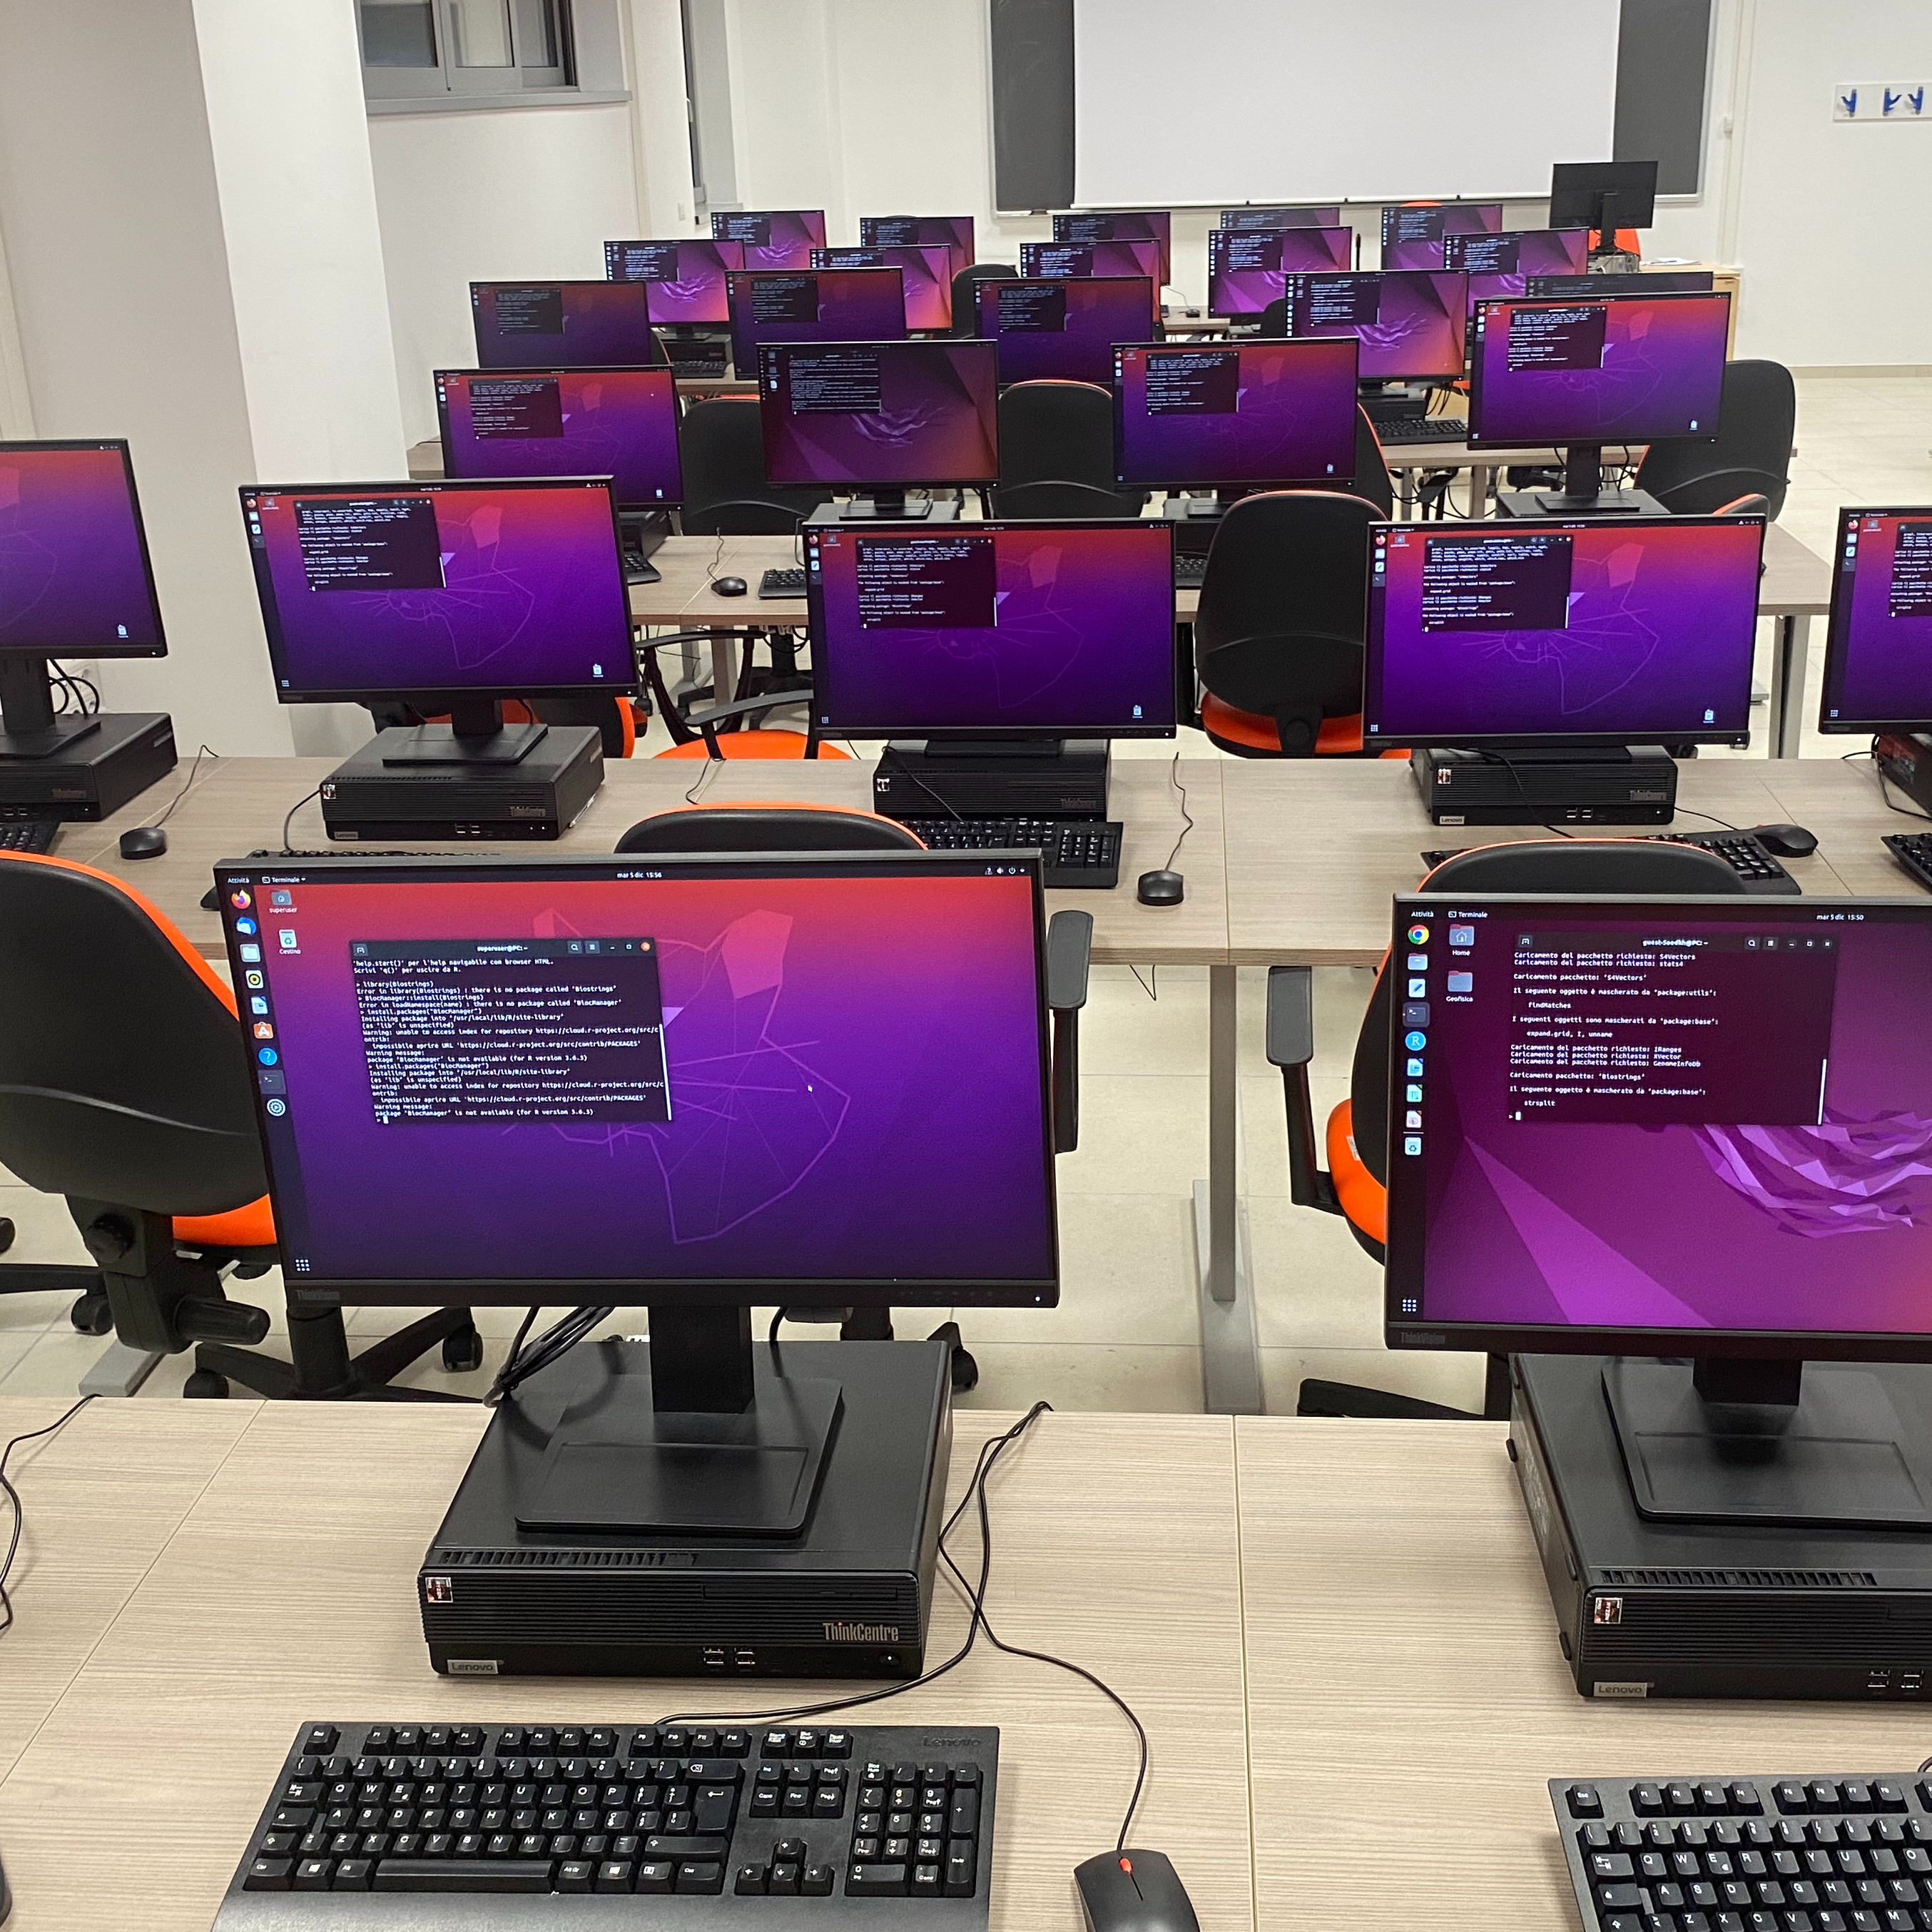
Laboratorio informatico
50 postazioni desktop con Ubuntu LTS e i principali strumenti bioinformatici per le attività di laboratorio.
-
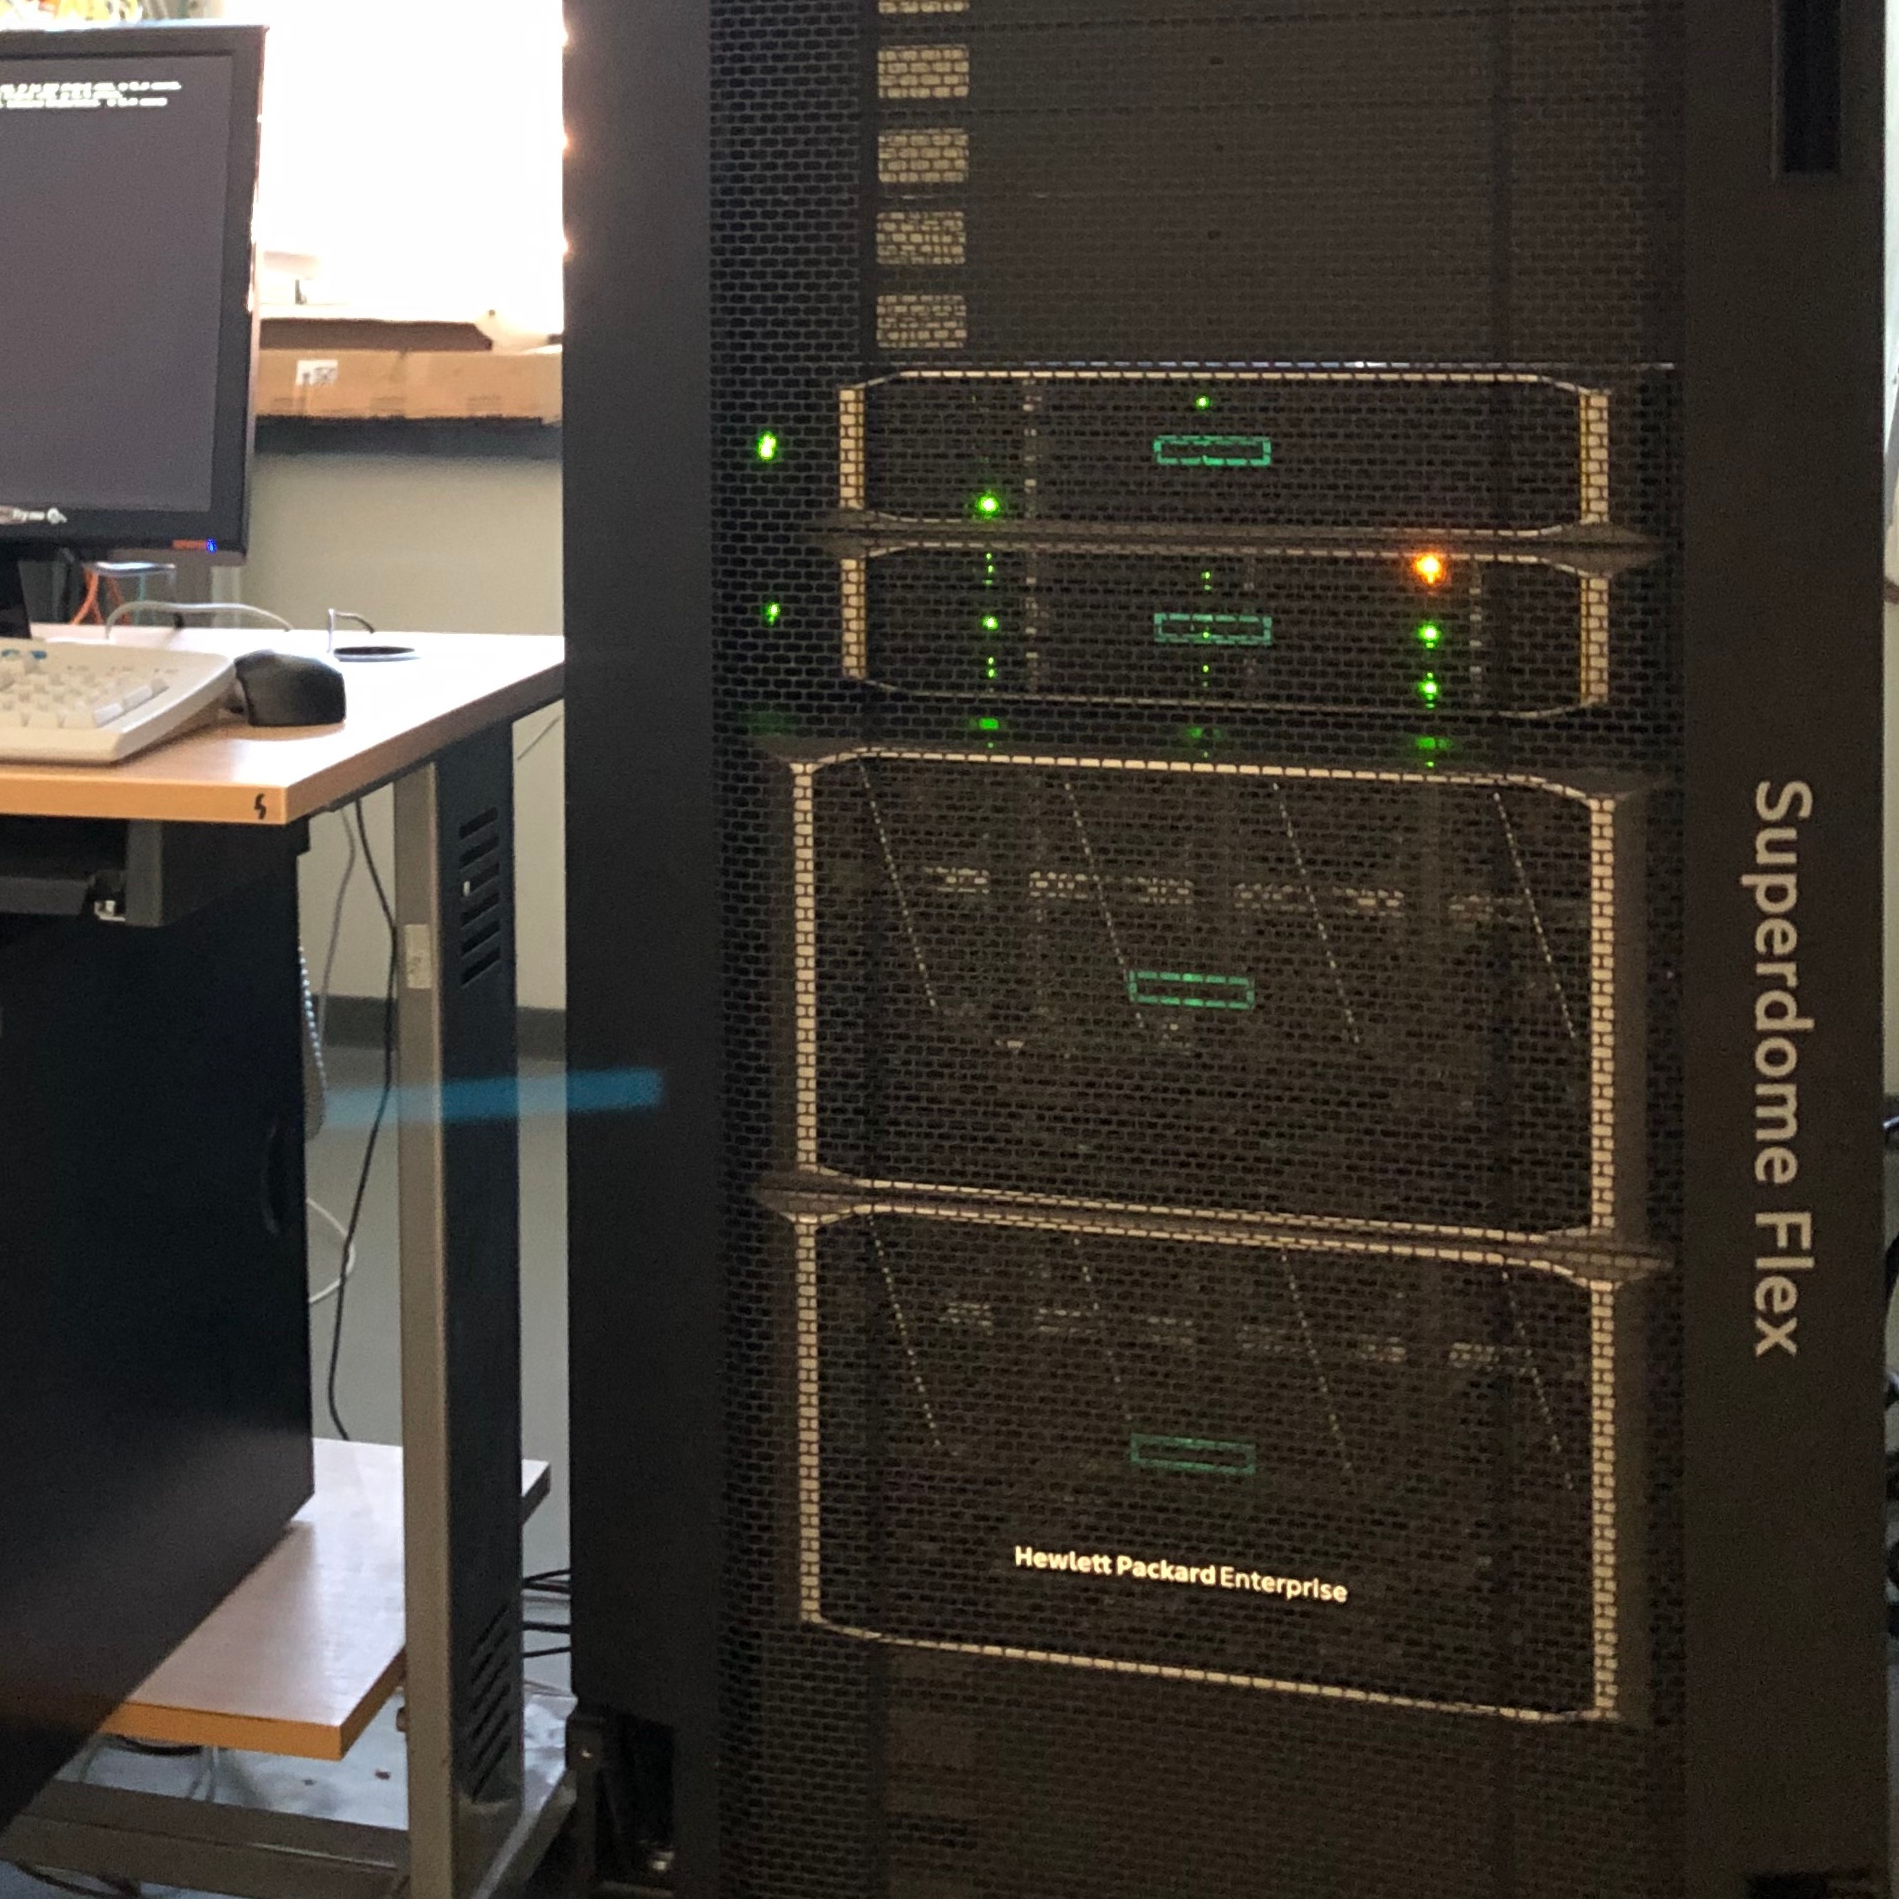
Superdome Flex
224 core CPU Intel(R) Xeon(R) Platinum 8280 @ 2.70GHz, 1,5 TB di RAM, 150 TB di storage, 1 GPU NVIDIA Tesla V100.
-
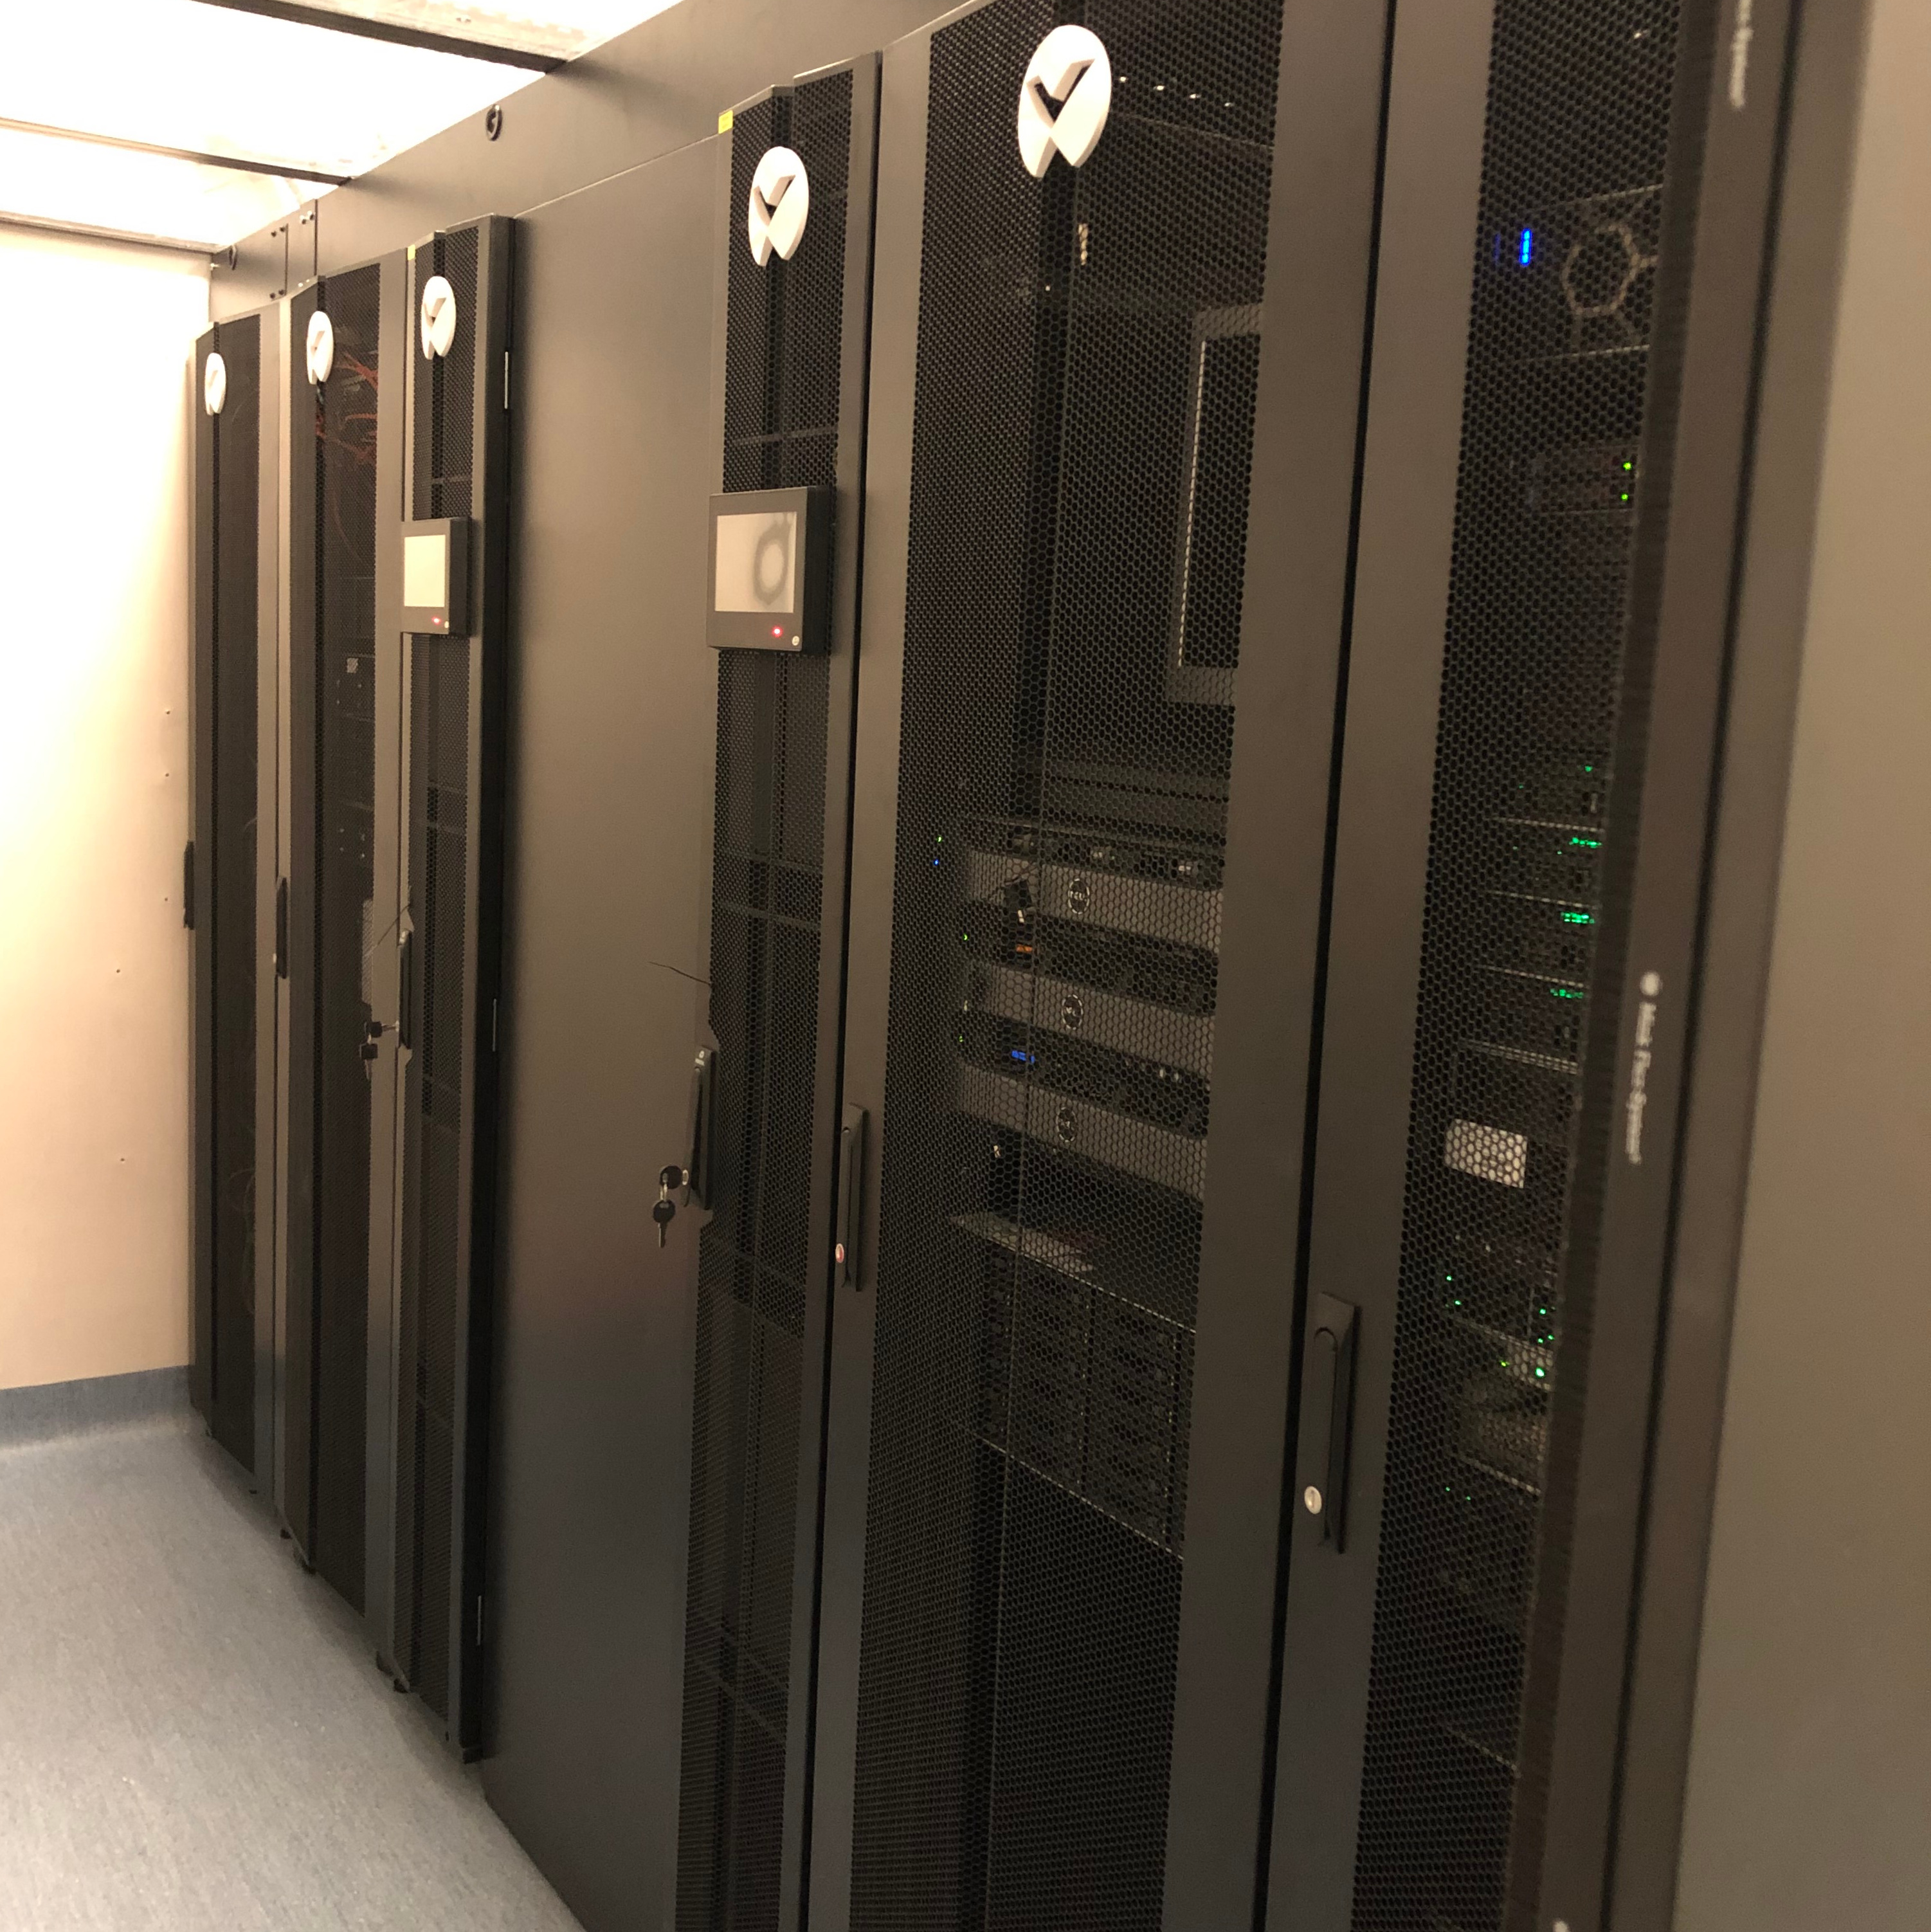
Cluster di server
Cluster di 7 server CPU e 1 unità GPU, per un totale di 400 core CPU, 4 TB di RAM, 600 TB di storage e 6 GPU NVIDIA. Ospitato presso Biogem - Istituto di Ricerche Genetiche "Gaetano Salvatore" ad Ariano Irpino (AV).
Persone
Membri attuali
Luigi Cerulo
Professore Associato
Direttore del Laboratorio
Francesco Napolitano
Professore Associato
Direttore del Laboratorio
Antonio Ammendola
Dottorando
Luca Faretra
Dottorando

Martina Palummo
Dottoranda

Mirella Sangiovanni
Dottoranda in visiting
Francesco Saccomando Ciaramella
Studente magistrale tirocinante
Angelo Cappuccio
Studente magistrale tirocinante
Martina Concilio
Tesista triennale
Ex membri

Marco Nigro
Ricercatore postdoc

Fiorella Mancini
Dottoranda
Erica Cogliano
Studentessa magistrale e tirocinante
Diana Parente
Studentessa triennale e tirocinante
Donatella Pierri
Tesista triennale
Felicita Masone
Tesista triennale
Manuel Maio
Tesista triennale

Chiara Circelli Gabriele
Tesista triennale

Mario Loiola
Tesista triennale
Roberto Paduano
Tesista triennale e tirocinante
Maria Chiara Armenise
Tesista triennale
Giorgia Miano
Tesista triennale
Tesi
Specializzazione di Large Language Models mediante LoRA: un'applicazione al dominio della bioinformatica
Roberto Paduano
Corso di Laurea in Biotecnologie, A.A. 2025/2026
L'intelligenza artificiale generativa in oncologia: il ruolo dei Large Language Models e dei Foundation Models multimodali
Giorgia Miano
Corso di Laurea in Biotecnologie, A.A. 2025/2026
Sviluppo del pensiero computazionale nello studio delle biotecnologie e delle STEM
Maria Chiara Armenise
Corso di Laurea in Biotecnologie, A.A. 2025/2026
Analisi strutturale delle interazioni tra proteine virali HPV, p53 e pep11 mediante strumenti di simulazione e intelligenza artificiale
Mario Loiola
Corso di Laurea in Biotecnologie, A.A. 2025/2026
Virtual screening basato su Machine Learning per l'identificazione di inibitori di CDK9
Diana Parente
Corso di Laurea Triennale in Biotecnologie, A.A. 2025/2026
Analisi bioinformatica delle strutture comuni in piccole molecole associate al carcinoma ovarico
Erica Cogliano
Corso di Laurea Magistrale in Biologia, Curriculum Biosanitario, A.A. 2025/2026
Meta-analisi degli studi di trascrittomica in endometriosi: prospettive per target terapeutici
Chiara Circelli Gabriele
Corso di Laurea Triennale in Scienze Biologiche, A.A. 2024/2025
I.A. e Farmacologia: un'analisi di Knowledge Probing su DeepSeek
Manuel Maio
Corso di Laurea in Biotecnologie, A.A. 2024/2025
Glioblastoma: metodi computazionali per la ricerca di una terapia differenziativa
Francesco Saccomando Ciaramella
Corso di Laurea in Biotecnologie, A.A. 2022/2023
Trascrittomica spaziale: effetti del trattamento con eme sull'espressione genica nel tessuto cerebrale murino in funzione della distanza dal sito di iniezione
Felicita Pia Masone
Corso di Laurea in Biotecnologie, A.A. 2021/2022
Studio del centrosoma e dello splicing citoplasmatico attraverso dati disponibili di trascrittomica
Donatella Pierri
Corso di Laurea Triennale in Biotecnologie, A.A. 2022/2023
Collaborazioni in corso


